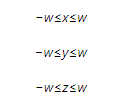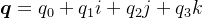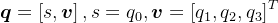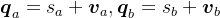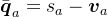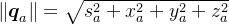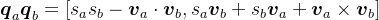乌啦呀哈呀哈乌啦!

欢迎光临,这里是喵pass的个人博客,希望有能帮到你的地方

0%

HybridCLR 为什么存在

Unity 常见的 C# 运行方式有两种:

  • Mono:运行 IL,可以使用 JIT,理论上比较容易动态加载 DLL。
  • IL2CPP:把 C# 编译成 IL,再转换成 C++,最后编译成原生机器码。

IL2CPP Player 发布以后,逻辑已经变成原生代码。后面下载一个新的普通 C# DLL,原版 IL2CPP 并没有完整的 IL 执行能力,因此无法像 Mono 那样直接运行。

HybridCLR扩充了IL2CPP的代码,为它增加了 IL 解释执行能力,使它由纯AOT Runtime变成“AOT+Interpreter“混合Runtime,进而原生支持动态加载Assembly,使得基于IL2CPP Backend打包的游戏不仅能在Android平台,也能在iOS、Consoles等限制了JIT的平台上高效地以AOT+interpreter混合模式执行。

通过 “Differential Hybrid dll” 技术,可以对 AOT dll 实现任意增删改,会智能地让 被修改或者新增的类和方法 以 Interpreter 模式运行,但 未被修改的类 以AOT方式运行,从而使 热更新的游戏逻辑 的运行性能基本达到原生AOT的水平。


基础原理

CLR,即Common Language Runtime,中文叫公共语言运行时,是让.NET程序执行所需的外部服务的集合,是.NET平台的核心和最重要的组件,类似于Java的JVM。

IL2CPP是Unity开发的跨平台CLR解决方案,诞生它的一个关键原因是Unity需要跨平台运行。但一些平台如iOS,这种禁止JIT并导致依赖JIT的官方CLR虚拟机无法运行,而是必须使用AOT技术将Mananged程序提前转化为目标平台的静态原生程序后再运行。而Mono虽然也支持AOT,但性能较差以及跨平台支持不佳。The IL2CPP backend converts MSIL (Microsoft Intermediate Language) code (for example, C# code in scripts) into C++ code, then uses the C++ code to create a native binary file (for example, .exe, .apk, or .xap) for your chosen platform.

IL2CPP方案包含一套AOT运行时以及一套DLL到C++代码及元数据的转换工具,使得原始的C#开发的代码最终能在iOS这样的平台运行起来。因为 IL2CPP 生成的 C++ 代码不是普通的 C++,它本质上还是在模拟 C# 的行为。很多 C# 特性在 C++ 里根本不存在,必须有额外代码来支撑。IL2CPP 只是把计算逻辑翻译成了 C++,但 C# 作为托管语言的那些”托管服务”,必须由运行时来提供。生成的 C++ 代码到处都在调用 il2cpp_xxx() 这类运行时 API,离开运行时根本跑不起来。

IL2Cpp运行时

Unity 在打包时就把 IL 代码转换成 C++ 源码,然后在开发者的机器上(或 CI 上)用目标平台的 C++ 编译器编译成 machinecode。最终交付给用户的已经是编译好的原生二进制,不是在用户设备上编译的。
所以用户设备上不需要安装 C++ 编译器,也不需要单独安装什么 IL2CPP runtime —— 它是随游戏一起打包分发的。

虽然代码本身已经变成了原生机器码,但 C#/.NET 的很多语言特性不只是代码逻辑,还依赖一个运行时环境。IL2CPP VM(更准确地说是 libil2cpp 运行时库)负责提供这些能力:

  1. 垃圾回收(GC):C++ 没有自动内存管理,需要运行时提供 GC(IL2CPP 用的是 BoehmGC)
  2. 类型系统和反射:typeof、GetType()、Activator.CreateInstance() 这些反射操作需要运行时维护类型元数据
  3. 泛型的运行时支持:某些泛型实例化需要运行时处理
  4. 线程管理:对应 .NET 的线程模型
  5. 异常处理:C# 的异常机制需要映射到原生代码的异常处理
  6. 平台抽象层:提供统一的 API 来屏蔽不同操作系统的差异

可以把它理解为:IL2CPP 把”程序逻辑”编译成了原生代码,但 C# 程序运行时还需要一个”服务层”来提供 GC、反射、类型系统等基础设施。这个服务层就是 IL2CPP runtime(所谓的”VM”)。它不是传统意义上解释执行字节码的虚拟机,更像是一个原生运行时库,和你的游戏代码一起编译、一起打包、一起运行。
它的角色类似于 .NET 程序依赖的 CoreCLR runtime,只不过 IL2CPP 的版本更轻量,且不包含 JIT 编译器。

  • 这个il2cpp runtime是由用户在目标设备上自行安装吗?还是随unity游戏项目一起打包?
  • 如果是这样,当一个用户设备上有多个unity引擎制作的游戏,会有多个重复的il2cpp runtime吗?

IL2CPP runtime 是随每个游戏一起打包的,不需要用户自行安装。如果用户设备上装了 3 个 Unity 游戏,就会有 3 份 IL2CPP runtime,各自独立存在于各自的应用包内。

  • 为什么不做成共享的系统级运行时?

这和 .NET Framework on Windows 的模式(系统全局安装一份,所有 .NET 程序共用)是完全不同的设计选择,原因包括:

  1. 版本耦合:每个游戏可能用不同版本的 Unity 构建,对应不同版本的 IL2CPP runtime。共享的话版本兼容性会是噩梦。
  2. 跨平台一致性:Unity 要支持 iOS、Android、主机等众多平台,不可能在每个平台上都推动安装一个系统级运行时。
  3. 自包含 = 可靠:游戏自带运行时,不依赖用户设备上装了什么,部署更可控。
  4. 体积可接受:libil2cpp 运行时库本身并不大(通常几 MB 级别),相对于游戏的贴图、音频等资源来说微不足道。

不只是 Unity,很多引擎和框架都这么做:

  1. Unreal Engine 的游戏也是各自打包完整的引擎运行时
  2. Electron 应用每个都自带一份 Chromium + Node.js
  3. Go / Rust 编译的程序都是静态链接、自包含的

本质上就是用少量磁盘空间换取部署的简单性和可靠性,在现代存储容量下这是非常合理的取舍。

HybridCLR核心构成

IL2CPP是一个纯静态的AOT运行时,不支持运行时加载DLL,因此不支持热更新;不像Mono有Hybrid mode execution,可支持动态加载DLL。

目前Unity平台的主流热更新方案xLua、ILRuntime之类都是引入一个第三方VM(Virtual Machine),在VM中解释执行代码,来实现热更新。这里我们只分析使用C#为开发语言的热更新方案。这些热更新方案的VM与IL2CPP是独立的,意味着它们的元数据系统是不相通的,在热更新里新增一个类型是无法被IL2CPP所识别的(例如,通过System.Activator.CreateInstance是不可能创建出这个热更新类型的实例),这种看起来像,但实际上又不是的伪CLR虚拟机,在与IL2CPP这种复杂的CLR运行时交互时,会产生极大量的兼容性问题,另外还有严重的性能问题。

HybridCLR 对 IL2CPP运行时进行扩充,添加Interpreter模块,将它由AOT运行时改造为“AOT + interpreter”双引擎的混合运行时,进而实现Mono hybrid mode execution这样的机制。这样一来就能彻底支持热更新,并且兼容性极佳。对开发者来说,除了解释模式运行的部分执行得比较慢,其他方面跟标准的运行时没有区别,完美支持在iOS这种禁止JIT的平台上以解释模式无缝地运行动态加载的DLL。

热更新流程

通常把业务逻辑放到独立的 asmdef,例如:

Game.Runtime 基础/AOT 程序集
Game.HotUpdate 热更新程序集

构建后得到 Game.HotUpdate.dll

  • 为了让 Unity 把 DLL 当作普通资源打进 AssetBundle,通常复制并改名为:Game.HotUpdate.dll.bytes

它在 AB 中只是一个 TextAsset,Addressables 下载后获取字节:

加载.dll.bytes文件
1
2
3
4
5
TextAsset hotDll = await Addressables
.LoadAssetAsync<TextAsset>("Game.HotUpdate.dll.bytes")
.Task;

Assembly hotAssembly = Assembly.Load(hotDll.bytes);

在 HybridCLR 环境中,Assembly.Load 会创建一个解释程序集映像。调用里面的方法时,HybridCLR 解释其 IL 指令。

AOT 与热更新代码互相调用

程序执行过程中可能发生:

热更新方法 → 热更新方法:解释执行
热更新方法 → Unity/AOT 方法:通过桥接调用原生代码
AOT 方法 → 热更新方法:通过接口、虚方法、委托、反射等进入解释器

解释器的参数布局与原生 ABI 不完全相同,所以 HybridCLR 会生成 Method Bridge,将参数、返回值、结构体、泛型等在解释器与 AOT 代码之间转换。

  • 什么是ABI
    ABI = Application Binary Interface,应用二进制接口,它规定了两段已经编译成机器码的程序,在二进制层面怎样互相调用
    例如热更新DLL中调用AOT方法: GameObject.Find(“Main Character”),GameObject.Find 是 Unity 已经 AOT 编译好的原生方法:热更新解释器栈中的参数 -> 原生 ABI参数
    或者Unity程序集调用hotEntry.Start(userId, token),这里 Start 在热更新 DLL 中:AOT 原生代码按 ABI 得到 userId、token -> Bridge 从寄存器/原生栈取出参数 -> 组装成 HybridCLR 解释器参数

这也是为什么 Player(游戏客户端) 发布前通常要执行 HybridCLR 的 Generate 流程,生成:

  • Method Bridge
  • Reverse P/Invoke Wrapper
  • AOT Generic References
  • link.xml
  • 其他 IL2CPP 辅助代码
    这些生成结果会被编译进 Player。以后热更新 DLL 如果引入了基础 Player 未覆盖的新桥接签名、被裁剪的 API 或特殊泛型,可能仍然需要重新发布 Player。

补充 AOT 元数据

HybridCLR 项目中还经常看到另一类 DLL:

mscorlib.dll.bytes
System.dll.bytes
Game.Runtime.dll.bytes
UnityEngine.CoreModule.dll.bytes

这些不是新的热更新逻辑,而是“AOT 补充元数据”。

IL2CPP 构建时会裁剪程序集,而且某些泛型实例、方法体和反射元数据不会完整保留。热更新代码可能需要这些信息,例如:

List<SomeHotUpdateType>
Dictionary<string, SomeHotUpdateType>
反射访问 AOT 类型

启动时先加载对应元数据:

1
2
3
4
RuntimeApi.LoadMetadataForAOTAssembly(
aotMetadataBytes,
HomologousImageMode.SuperSet
);

然后再加载热更新 DLL。

AOT 元数据必须来自对应平台、对应 Player 基线的 HybridCLR/IL2CPP 构建产物,不能随意拿 Editor DLL、Android DLL给 iOS,也不能拿新 Player 的元数据给旧 Player。

与其他热更新方案对比

HybridCLR是原生的C#热更新方案。通俗地说,IL2CPP相当于Mono的AOT模块,HybridCLR相当于Mono的Interpreter模块,两者合一成为完整Mono。HybridCLR使得IL2CPP变成一个全功能的Runtime,原生(即通过System.Reflection.Assembly.Load)支持动态加载DLL,从而支持iOS平台的热更新。

正因为HybridCLR是原生Runtime级别实现,热更新部分的类型与主工程AOT部分类型是完全等价并且无缝统一的。可以随意调用、继承、反射或多线程,不需要生成代码或者写适配器。

其他热更新方案则是独立VM,与IL2CPP的关系本质上相当于Mono中嵌入Lua的关系。因此类型系统不统一,为了让热更新类型能够继承AOT部分类型,需要写适配器,并且解释器中的类型不能为主工程的类型系统所识别。特性不完整、开发麻烦、运行效率低下。
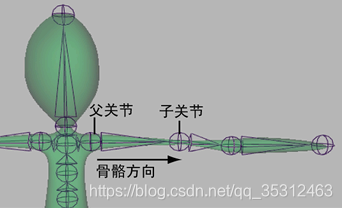
关节坐标的定义和计算方法

  1. 绑定姿势:这是网格绑定到骨骼之前的姿势,通常是设计师在绑定模型时预设的。绑定姿势通常在一个T型姿势(T-Pose)下进行记录‌。
  2. 局部姿势:这是关节相对于父关节来指定的常见姿势。局部姿势存储为TQS格式,表示相对于父关节的位置、朝向和缩放。根关节的父节点可以认为是世界坐标系的原点。在数学上,关节姿势是一个仿射变换,由平移向量、旋转矩阵和对角缩放矩阵组成‌。

骨架由一系列具有层次关系的关节(骨骼)和关节链组成,是一种树结构,选择其中一个是根关节,其它关节是根关节的子孙,可以通过平移和旋转根关节移动并确定整个骨架在世界空间中的位置和方向。父关节运动能影响子关节运动,但子关节运动对父关节不产生影响,因此,平移或旋转父关节时,也会同时平移或旋转其所有子关节。


Unity动画系统

分为旧版动画系统和新版动画系统,即AnimationClip 与 Animator(Mecanim)

  • AnimationClip
    Plays specific Animation Clips directly via script (e.g., Animation.Play(“Jump”)). It has no built-in state machine or visual graph.

  • Animator/Mecanim (New)
    Attach a animator component to your GameObject. It requires an Animator Controller asset to function.
    It uses a visual graph to manage states. You rarely tell it to “Play” a clip; instead, you change a parameter (e.g., animator.SetFloat(“Speed”, 5.0f)), and the state machine decides which animation to play.

3D模型

  1. 绑定 (Rigging)
    指为3D模型创建内部骨骼、关节及控制器系统,定义运动逻辑,给角色搭建“骨架”和“控制系统”的过程,类似于给木偶安装操纵线。
  • 目的: 赋予模型生命,使动画师能方便地操纵复杂的几何体。
  • 组成: 包含骨骼(Joints)、控制器(Controllers)、IK/FK(逆向/正向动力学)链。
    工作内容: 放置关节、设置骨骼层级、添加IK把手、创建控制器。
  1. 蒙皮 (Skinning)
    蒙皮是绑定完成后的步骤,将模型的顶点(Vertex)“绑定”到骨骼上。
    目的: 让骨骼驱动模型网格变形。当骨骼移动时,皮肤上的顶点会随之移动。
    方法:
  • 平滑蒙皮(Smooth Skinning): 顶点受多个骨骼影响,变形平滑自然(最常用)。
  • 刚性蒙皮(Rigid Skinning): 一个顶点只受一个骨骼影响,变形较生硬。
    关键概念——刷权重(Weighting): 定义顶点受特定骨骼影响的程度(0-1之间)。将Mesh网格的顶点与骨骼节点对应,从而决定模型的不同部位要跟着关节位移的程度
  1. 制作关键帧动画
    IK骨(Inverse Kinematics,反向动力学)通过设置骨骼末端(如手、脚)的目标位置,计算系统会自动推算出其他关节(如手腕、肘部)的移动
  • IK骨不是被反推的骨头的子节点,而是以外的骨头(例如大腿->小腿->脚,此时IK骨则不为这三个骨头的子节点)
  • Chain Length:有多少根节点骨头要反算
  • Pole Target:被影响关节的朝向方向

Shader(着色器)是一段运行在 GPU 上的程序,用来决定物体怎么被画出来。 比如物体是什么颜色、有没有反光、表面是否透明,以及是否出现发光、溶解等效果。

在 Unity 中,可以这样理解它们的关系:

  • 模型(Mesh):提供形状,例如一个球。
  • 贴图(Texture):提供图案,例如球表面的木纹。
  • Shader:规定如何处理光照、贴图和颜色,让球看起来像木头、金属或玻璃。
  • 材质(Material):选择一个 Shader,并设置贴图、颜色、光滑度等具体参数,然后赋给物体。

同一个球模型,使用不同 Shader 和材质,就能呈现完全不同的外观。

常见的 Shader 处理阶段有:

阶段 作用
顶点着色器(Vertex Shader) 处理模型顶点的位置,可以实现波浪、树叶摇摆等形变
片元着色器(Fragment Shader) 计算表面每个片元的颜色,可以实现光照、透明、渐变等效果

“片元”可以先理解成一个准备画到屏幕上的像素候选,它还可能被深度测试等步骤丢弃。

在 Unity 里,你可以直接使用内置 Shader,也可以用 Shader Graph 连接节点来制作效果,或者用 HLSL 写代码。

例如做一个“物体逐渐溶解”的效果,Shader 会根据噪声贴图和溶解参数,丢弃一部分片元,并给溶解边缘加上发光颜色。


Credits:

https://zhuanlan.zhihu.com/p/718015588


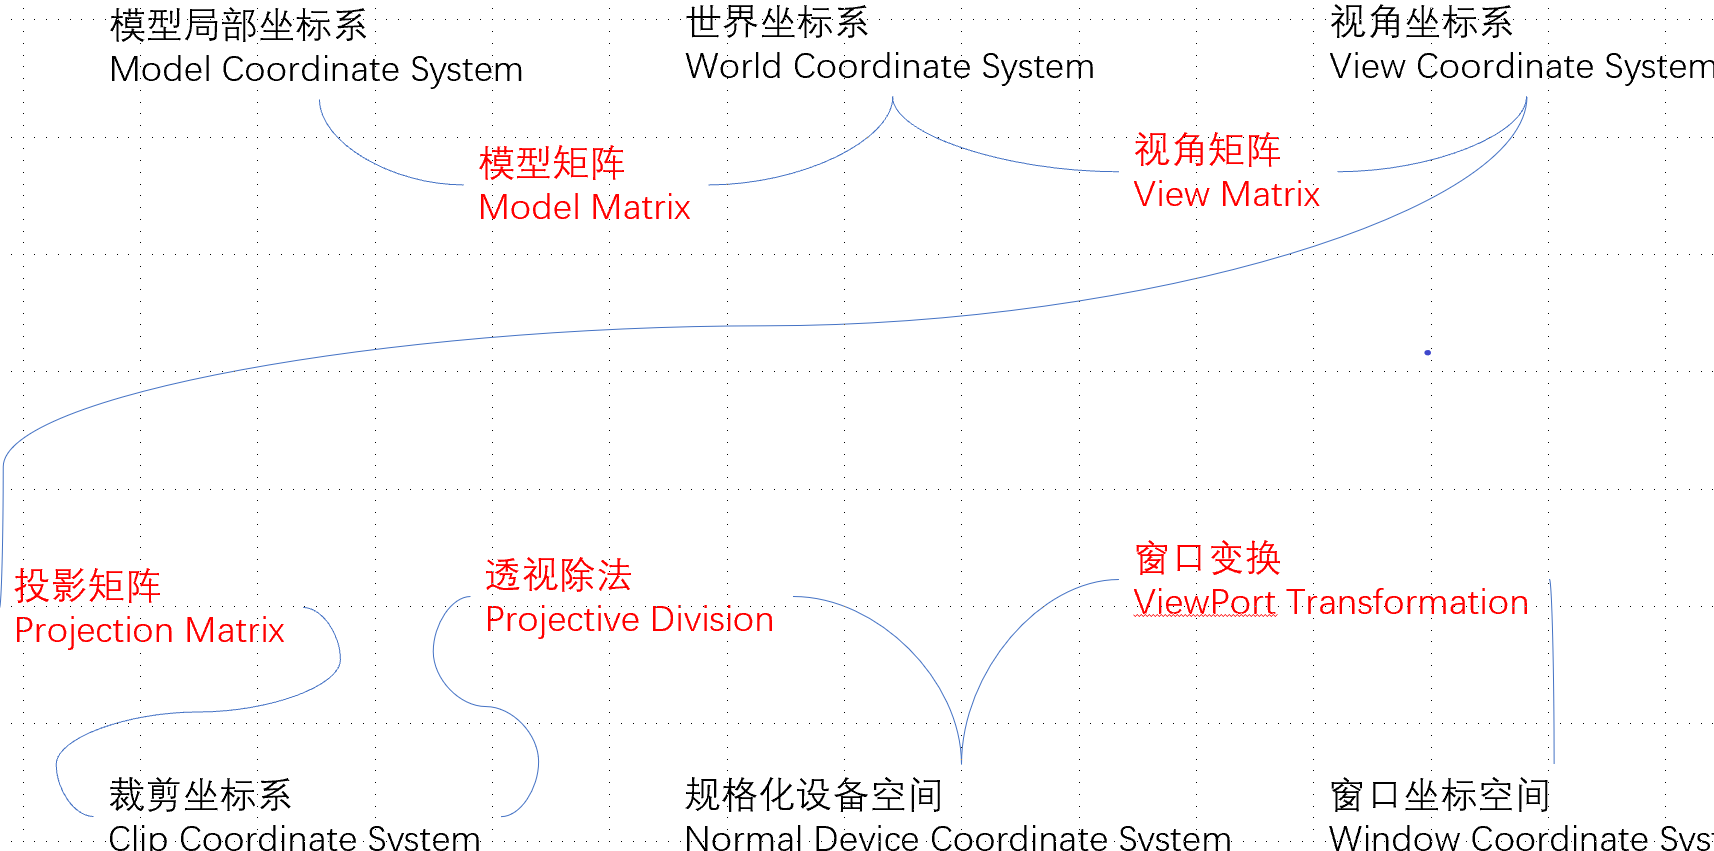
Vertex Shader的输出在Clip Space,然后GPU自己做透视除法变到了NDC( 取值范围[-1, 1] )。


裁剪空间

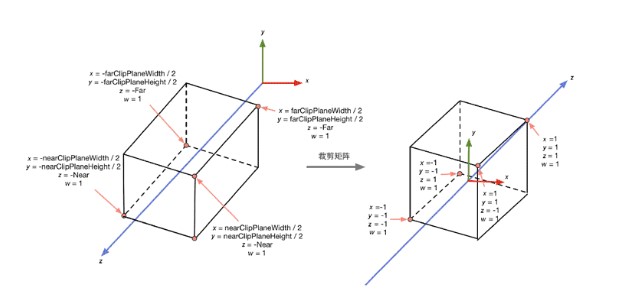
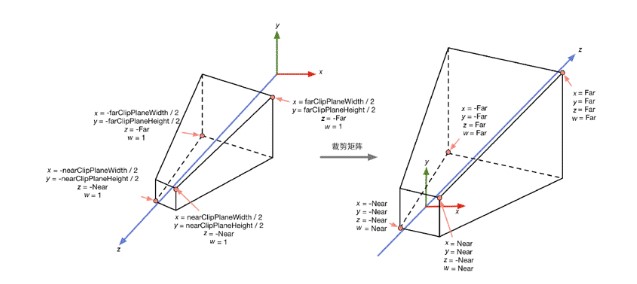
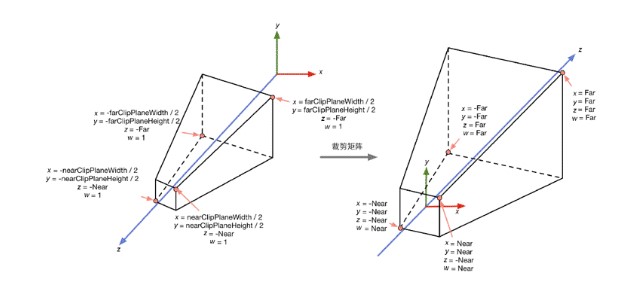
裁剪空间变换的思路是,对平截头体进行缩放,使近裁剪面和远裁剪面变成正方形,使坐标的w分量表示裁剪范围,此时,只需要简单的比较x,y,z和w分量的大小即可裁剪图元。
完全位于这块空间内部的图元将会被保留,完全位于这块空间外部的图元将会被剔除,与这块空间边界相交的图元就会被裁剪。而这块空间就是由视椎体来决定的。

In clip space, clipping is not done against a unit cube. It is done against a cube with side-length w. Points are inside the visible area if each of their x,y,z coordinate is smaller than their w coordinate.

In the example you have, the point [6, 0, 6.29, 7] is visible because all three coordinates (x,y,z) are smaller than 7.

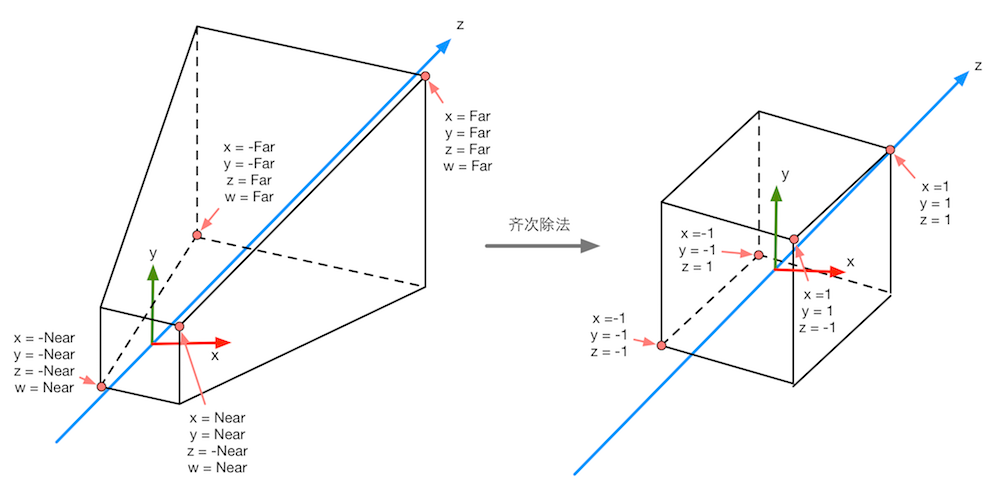
透视投影矩阵


此时我们就可以按如下不等式来判断一个变换后的顶点是否位于视椎体内

正交投影矩阵


判断一个变换后的顶点是否位于视椎体内使用的不等式和透视投影中的一样,这种通用性也是为什么要使用投影矩阵的原因之一。


NDC

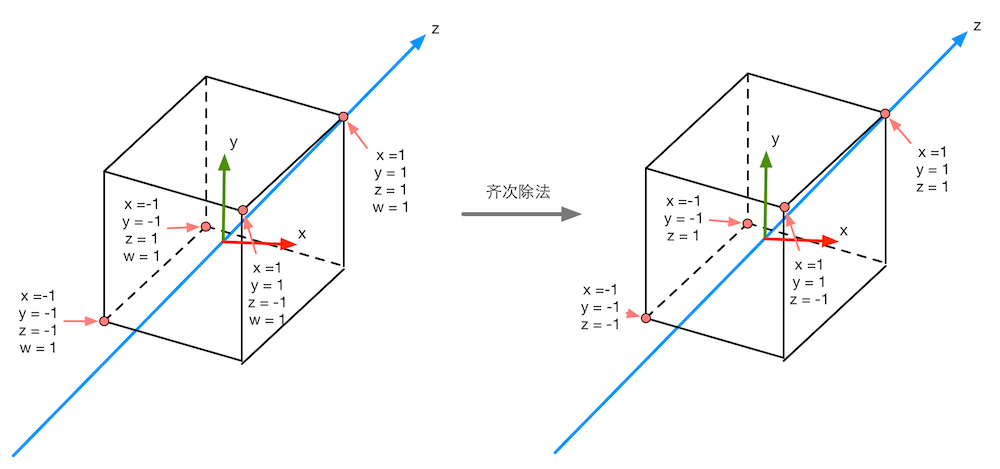
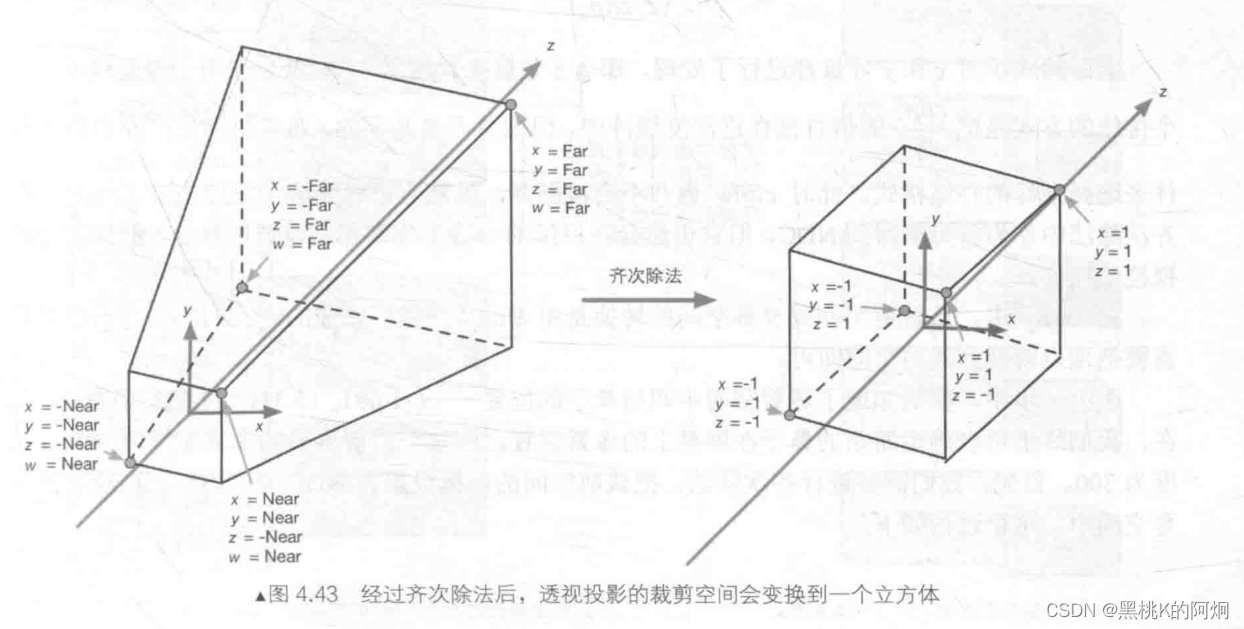
齐次除法将Clip Space顶点的4个分量都除以w分量,就从Clip Space转换到了NDC了。
而NDC是一个长宽高取值范围为[-1, 1]的立方体,超过这个范围的顶点,会被GPU剪裁。也就是说,每个顶点的x,y,z坐标都应该在-1.0到1.0之间,超出这个坐标范围的顶点都将不可见。

透视投影除法

正交投影除法


细心一点会发现,齐次坐标对于透视投影空的裁剪空间变化更大,而对正交投影的裁剪空间没有影响(正交投影的裁剪空间中顶点的w已经是1了)。

视口变换(Viewport Transformation)

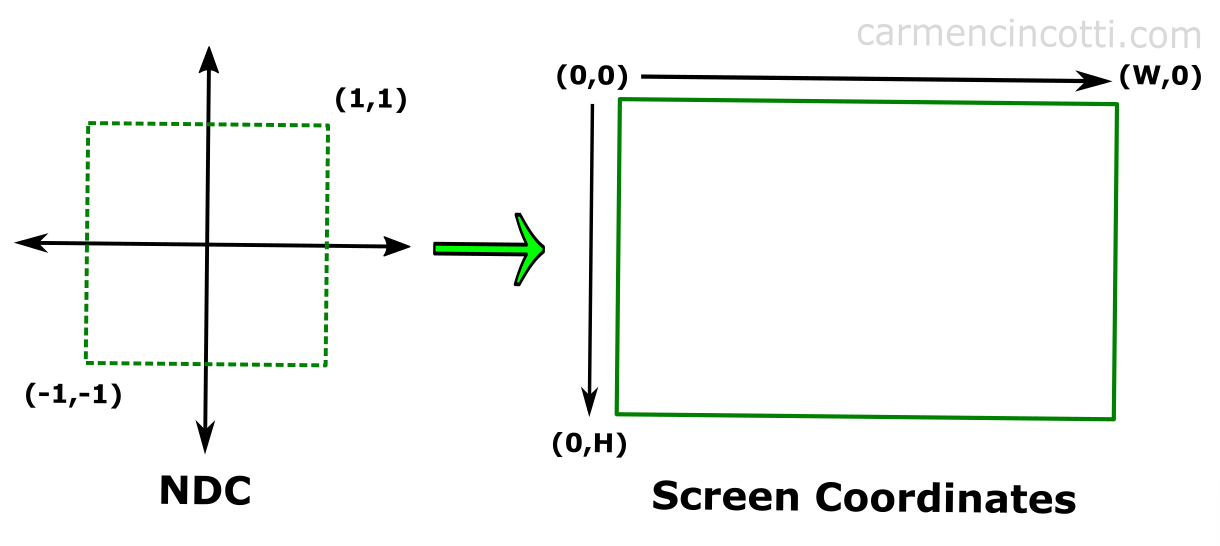
At this moment, we’re still in 3D space.How do we get to 2D space?

We need to transform our vertex from 3D NDC to 2D screen coordinates.

When initializing the Canvas, we are responsible for configuring its size. This size is used to convert our NDC coordinates to screen coordinates.

No Dependency Injection

不使用依赖注入,必须在依赖方(Dependent Class)中主动创建或者获取被依赖方(Denpendency Class)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
public class ClassA
{
private readonly ClassB _classB;

public ClassA()
{
_classB = new ClassB(); //主动创建对象B
}

public void Process()
{
Console.WriteLine("Class A start process");
_classB.DoSomething();
Console.WriteLine("Class A finish process");
}
}

public class ClassB
{
public void DoSomething()
{
// ClassB performs some logic
}
}

Denpendency Injection and IoC

使用依赖注入,不需要在依赖方的代码里主动创建或者获取被依赖方,反而,只需要在构造器参数里声明需要对象B的引用。

ClassA.cs
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
public class ClassA
{
private readonly IInterfaceB _b;

public ClassA(IInterfaceB b)
{
_b = b;
}

public void Process()
{
Console.WriteLine("Class A start process");
_b.DoSomething();
Console.WriteLine("Class A finish process");
}
}

在使用依赖注入时,更多时候,对于依赖更提倡使用接口,这样解耦了接口和实现:ClassA不需要知道ClassB的内部,只需要知道IClassB有个叫DoSomething的方法可以调用
并且,业务代码中不需要主动实例化对象,即无需这样主动调用构造函数 new ClassA(new ClassB())

ClassB.cs
1
2
3
4
5
6
7
public class ClassB : IClassB
{
public void DoSomething()
{
Console.WriteLine("class B is doing something ...");
}
}
IClassB.cs
1
2
3
4
public interface IClassB
{
void DoSomething();
}
Program.cs
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
internal class Program
{
public static void Main(string[] args)
{
IHost host = Host.CreateDefaultBuilder(args)
.ConfigureServices((context, services) =>
{
services.AddSingleton<ClassA>();
services.AddSingleton<IInterfaceB, ClassB>();
}).Build();

ClassA a = host.Services.GetRequiredService<ClassA>();
a.Process();
}
}

原本是在ClassA内部决定使用怎样的ClassB实例,使用了依赖注入设计后,这种控制关系(决定关系)变为由外部控制了,这就是所谓的“控制反转”(Inversion of Control)

  • Host 以及它内部的 Services可以理解为 C# 提供的依赖注入系统
  • 通过 GetRequiredService 可以获得对应的实例并执行业务逻辑(此处为ClassA实例)

使用依赖注入系统实例化对象

如果我们想要达到不需要手动实例化ClassA的效果,可以新建一个类并实现IHostedService接口

DoSomethingHostedService.cs
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public class DoSomethingHostedService : IHostedService
{
private readonly ClassA _a;

public DoSomethingHostedService(ClassA a)
{
_a = a;
}

public Task StartAsync(CancellationToken cancellationToken)
{
_a.Process();
return Task.CompletedTask;
}

public Task StopAsync(CancellationToken cancellationToken)
{
return Task.CompletedTask;
}
}
修改 Program.cs
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
internal class Program
{
public static async Task Main(string[] args)
{
IHost host = Host.CreateDefaultBuilder(args)
.ConfigureServices((context, services) =>
{
services.AddSingleton<ClassA>();
services.AddSingleton<IInterfaceB, ClassB>();

services.AddHostedService<DoSomethingHostedService>();
}).Build();

await host.RunAsync();
}
}
  • IHostedService 是一个特殊的接口,实现这个接口的类通过在Host中的services里注册后,可以在Host运行时自动实例化并执行
  • services.AddHostedService<>() 用于注册要自动执行的类
  • await host.RunAsync() 运行Host实例

Credits:

https://zhuanlan.zhihu.com/p/592698341


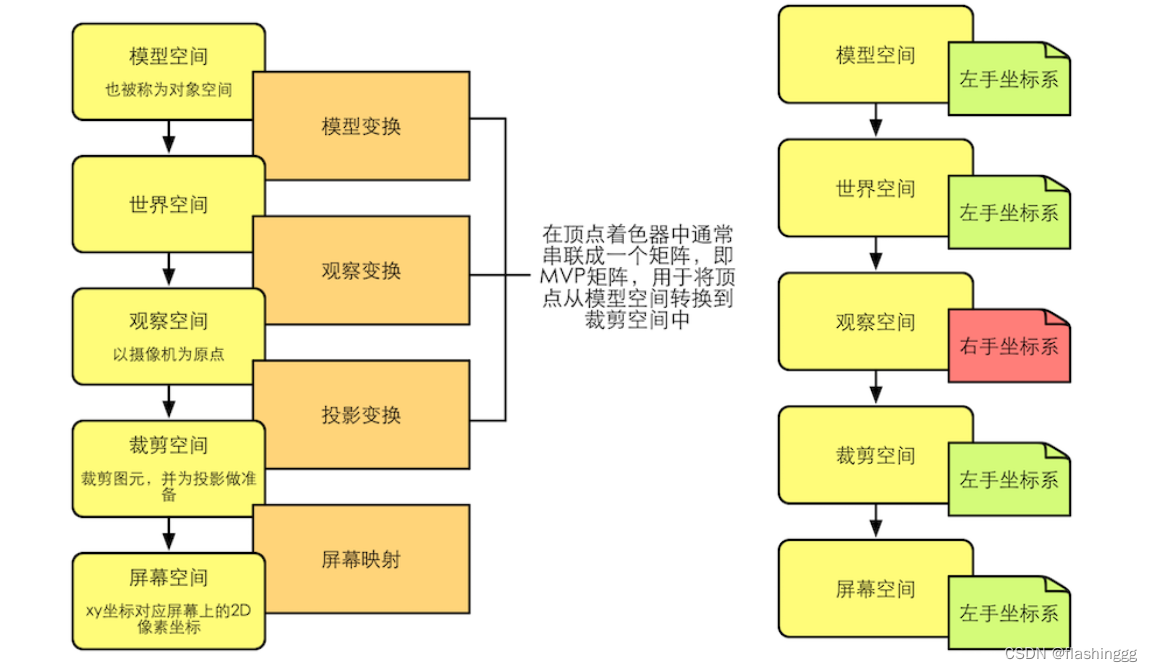
坐标空间有:世界空间、模型空间、摄像机空间、齐次裁剪空间、屏幕空间,以及法线映射会用到的切线空间(之前的纹理基础篇就讲到过)。

那为什么会有这么多个坐标空间呢?

一些概念只有在特定的坐标空间下才有意义,才更容易理解。这就是为什么在渲染中我们要使用这么多坐标空间。

——《Unity Shader 入门精要》

  • 坐标空间转换:在渲染管线中,把一个点或一个向量从一个坐标空间转换到另一个坐标空间,比如模型空间 -> 裁剪空间
  • 变换矩阵:实现坐标空间转换的过程,则需要用到变换矩阵
  • 顶点着色器:顶点着色器是图形渲染管线中对每个顶点进行坐标变换的程序,而MVP变换(模型Model - 视图View - 投影Projection)是顶点着色器中一种将顶点坐标从模型空间转换为裁剪空间的常用技术。

1. 模型空间(Model Space)

又称为对象空间(Object Space)或局部空间(Local Space),每个模型都有属于自己的模型空间

  • 以模型本身为参考系,会随着模型的旋转/移动而旋转/移动
  • 包含前、后、左、右等自然方向概念.

在模型空间中描述模型上的某一点位置时,坐标会被扩展到齐次坐标系下:(1,0,0) -> (1,0,0,1),为顶点变换中的平移变换做准备

顶点变换Step 1 - 模型变换(MVP中的M)

Model Transformation 把3D物体从模型空间变换到世界空间

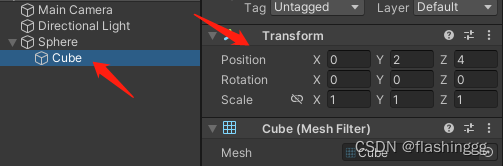
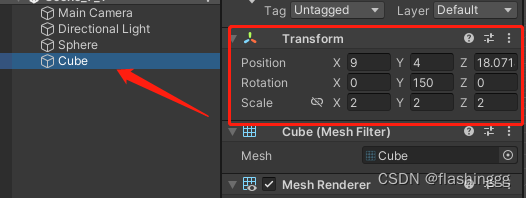
在Unity中,我们直接给Cube拖出来就行

我们发现,Cube位置从(0, 2, 4, 1) -> (9, 4, 18.071),unity帮助我们把Cube的坐标完成了模型变换


2. 世界空间(World Space)

游戏场景中的最大空间,一般世界空间的原点会放在游戏空间的正中心,同时世界空间的位置就是绝对位置——这个绝对位置你可以理解成Unity里没有父节点(parent)的游戏对象的位置。

顶点变换Step 2 - 观察变换(MVP中的V)

View Transformation 把3D物体从世界空间变换到观察空间

此时的变换矩阵等于:把观察空间当做一个模型空间,将其变换到世界空间(用模型变换的方法),然后取此变换矩阵的逆即为 观察空间 <- 世界空间

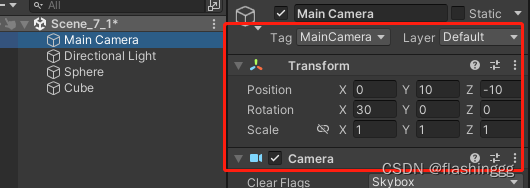
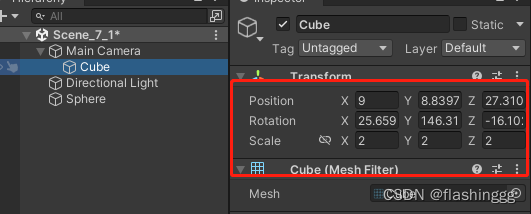
在unity中,我们可以直接把Cube从世界空间拖到Main Camera下,此时Cube的Transform组件变为观察空间下的坐标信息

我们发现Cube位置变为(9, 8.839, 27.310),但此时Transform信息是左手坐标系下的,因此正确描述在观察空间中的Cube坐标应为(9, 8.839, -27.310)


3. 观察空间(View Space)

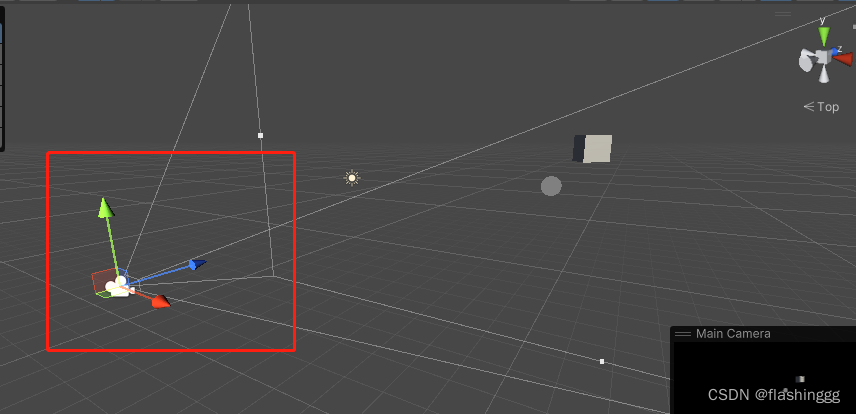
也叫做摄像机空间(Camera Space),摄像机在场景中不可见,但是一般会给它生成一个图标并在场景窗口可视化,例如:

  • In Unity’s camera/view space, the forward direction (the direction the camera is looking) is along the negative Z-axis. This means objects further away from the camera will have larger negative Z values in view space.
  • 注意区分观察空间和屏幕空间,观察空间是3d,屏幕空间是2d,观察空间 -> 屏幕空间需要经过投影操作

顶点变换Step 3 - 投影变换(MVP中的P)

Projection Transformation 把3D物体从观察空间变换到裁剪空间

观察空间->裁剪空间的变换矩阵有更准确的称呼 —— 裁剪矩阵(Clipping Matrix),也被叫做投影矩阵(Projection Matrix)。
此时的坐标为顶点着色器的输出,即图元顶点在裁剪空间中的坐标。


4. 裁剪空间(Clip Space)

也被称为其次裁剪空间,渲染管线中几何阶段的裁剪步骤在这一环节完成,这一环节里我们无法操控(Non-programmable),完全由GPU去做

4.1 视锥体

从观察空间到屏幕空间的途中,需要经过裁剪空间,其目的在于剔除在视野范围外的图元,而由视锥体(Frustum)决定的裁剪空间为这一剔除过程提供了便利。
很显然,场景越大,裁剪的优越性更加突出,如果不进行裁剪就直接投影到2d屏幕空间,后续会产生非常多不必要的开销,例如渲染完全在电脑屏幕外的图元。

视锥体是观察空间中的一块区域,决定着摄像机的可见范围(即最终在屏幕上可见并渲染的物体),它由六个面组成,被称为裁剪平面(Clipping Planes)。

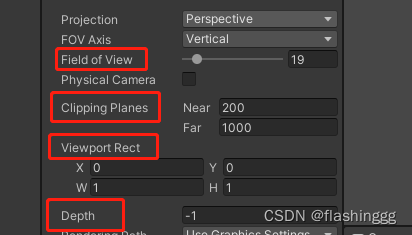
4.1.1 透视投影

  • FOV: 视角度数,同时FOV Axis决定这个视角是横向还是纵向
  • Clipping Planes: 设置近裁剪平面距离 和 远裁剪平面距离
  • Viewport Rect: This refers to the Camera.rect property, which defines the portion of the screen where a camera’s view is drawn. By adjusting these values, you can control where a camera renders on the screen and how much of the screen it occupies. This config is commonly used for split-screen effects.
  • Depth: This property controls the order in which multiple cameras in a scene render their output. A camera with a lower depth value renders before a camera with a higher depth value. This is crucial for achieving effects like picture-in-picture, UI overlays, or rendering specific layers with different cameras. If multiple cameras have the same depth value, their rendering order is determined by their order in the scene hierarchy.

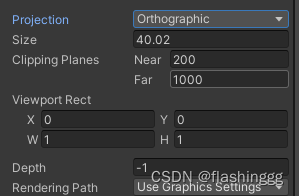
4.1.2 正交投影

4.2 投影矩阵的目的

前面已经讨论过了裁剪的必要性 —— 进行渲染提出视野范围外的图元;这里需要讨论的是,为何不在视锥体裁剪,而是要先变换到裁剪空间再进行裁剪?

《Unity Shader 入门精要》中做了很清楚的解释:“直接在视锥体定义的空间进行裁剪,对于透视投影的视锥体想要判断一个顶点是否在这个空间内是十分麻烦的,我们需要一种更加通用、整洁方便的方式进行裁剪,因此就需要一个投影矩阵将顶点转换到一个裁剪空间(Clip space)中。”

从观察空间到裁剪空间的变换叫做投影变换。虽然叫做投影变换,但是投影变换并没有进行真正的投影。

4.2.1 为真正的投影做准备

真正的投影可以理解成空间的降维,4d -> 3d,3d -> 2d,真正的投影发生在屏幕映射过程中对顶点进行齐次除法后获得其二维坐标这一步,而投影矩阵只是进行了坐标空间转换,并没有实实在在地进行投影这一操作。
齐次(裁剪)空间实质上是一个四维空间,变换到齐次空间的顶点之间仍然是线性相关的,可以使用线性插值。(此时没有除以W变成3D坐标,是齐次坐标)

4.2.2 对x、y、z进行缩放

投影矩阵虽然叫做投影矩阵,但并没有真正进行投影,而是为投影做准备。经过投影矩阵的缩放后,我们可以直接使用w分量作为范围值,只有x,y,z分量都位于这个范围内的顶点才认为是在裁剪空间内。并且w分量在真正的投影时也会用到。


标准化设备坐标(Normalized Device Coordinate)

在齐次裁剪空间的基础上进行透视除法(Perspective division)或称齐次除法(Homogeneous division),得到的坐标叫做NDC空间坐标。

  • 裁剪空间是顶点乘以MVP矩阵之后所在的空间,Vertex Shader的输出就是在裁剪空间上(划重点)。
  • 接着由GPU自己做透视除法,将顶点转移到标准化设备坐标(NDC)。


5. 屏幕空间(Screen Space)

完成了裁剪工作,下一步就是进行真正的投影了,将视锥体投影到屏幕空间中,这一步会得到真正的像素位置,而不是虚拟的三维坐标。
这一环节可以理解为做了以下两步:

5.1 齐次除法

首先进行标准齐次除法(homogeneous division),也被称为透视除法(perspective division),其实就是x、y、z分别除以w,经过齐次除法后的裁剪空间会变成一个单位立方体,这个立方体空间里的坐标叫做归一化的设备坐标(也就是之前提到的NDC)。因此,也可以说齐次除法是做了空间裁剪坐标到NDC坐标的转换操作。

5.2 屏幕映射(渲染管线中几何阶段的一步)

这里就顺利的跟之前的渲染管线GPU负责的几何阶段部分联系在一起了。在获得了NDC立方体后,接下来就是根据变换后的x、y坐标映射输出窗口对应的像素坐标,本质就是个缩放的过程。

  • 虽然屏幕是2d空间,但z分量此时并没有被抛弃,会被储存起来(深度缓存或者其他的储存格式)

我们前面说到Vertex Shader的输出在Clip Space,接着GPU会做透视除法变到NDC。这之后GPU还有一步,应用视口变换(Viewport Transformation),转换到屏幕空间,输入给Fragment Shader:

(Vertex Shader) => Clip Space => (透视除法) => NDC => (视口变换) => Window Space => (Fragment Shader)


Credits:

MVP矩阵:https://blog.csdn.net/qq_41835314/article/details/126851074


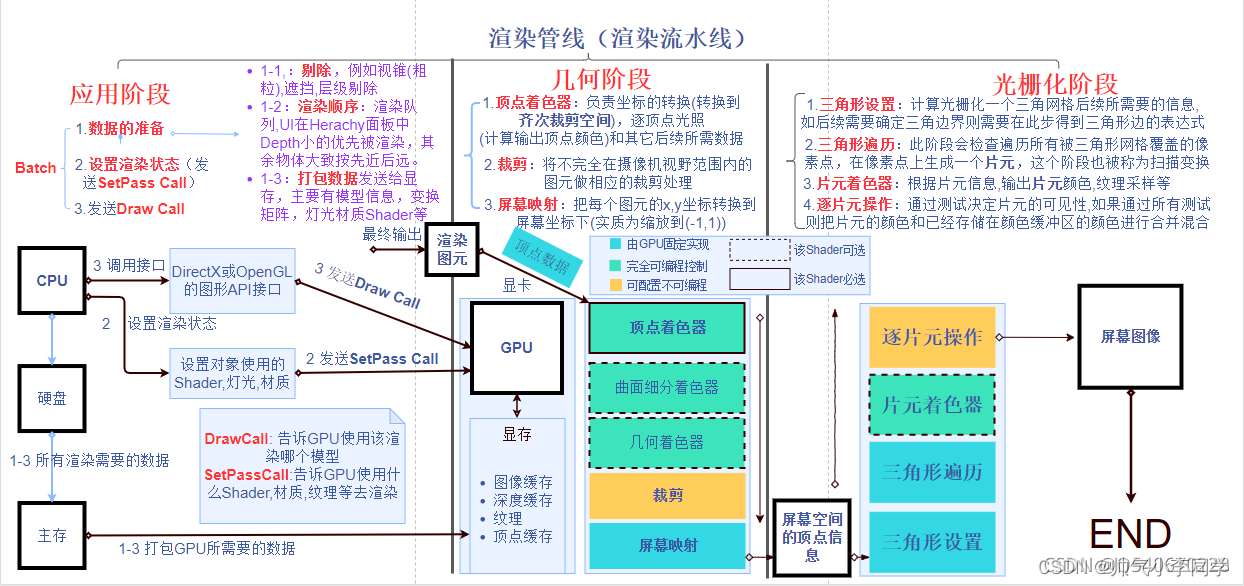
CPU + GPU工作流程

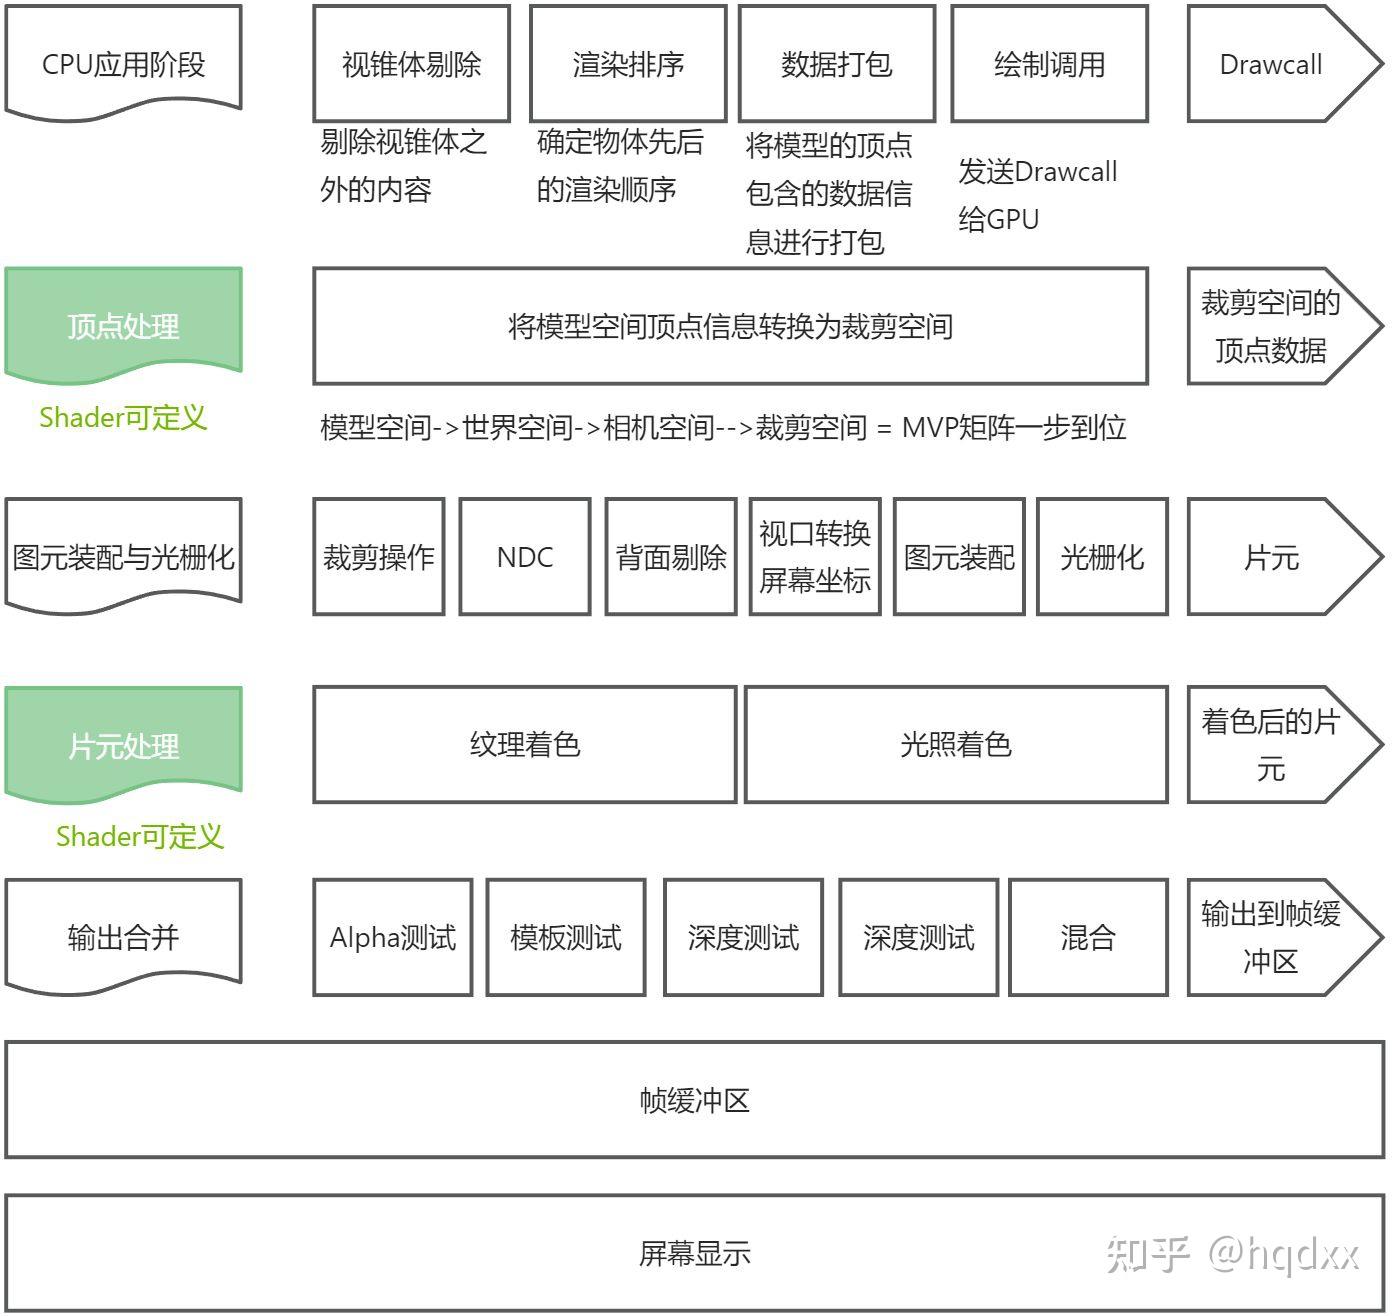
  1. 剔除,把一些不想看到的,或者看不到的东西排除掉
  2. 确定物体的先后渲染顺序
  3. 将对应的模型数据、材质等打包发送给GPU
  4. 发送SetPassCall和Drawcall告诉GPU渲染管线渲染模型数据所需的shader
  5. 数据在GPU渲染管线中绘制,将3D物体渲染为2D图像
  6. 将渲染图像存放在帧缓冲区(FrameBuffer)中。可以理解为一个和屏幕大小等大的临时画布
  7. 后处理操作。通过CPU拿到帧缓冲区的图像,调用shader再进入GPU渲染管线,对帧缓冲区的图像进行二次的修改,比如调色、bloom等操作
  8. 显示在屏幕上

CPU应用程序端逻辑:经过剔除、排序等等,将模型数据打包发给GPU渲染管线
GPU渲染管线:拿到模型数据后,讲图像画出来,存放在对应的帧缓冲区中


GPU渲染管线

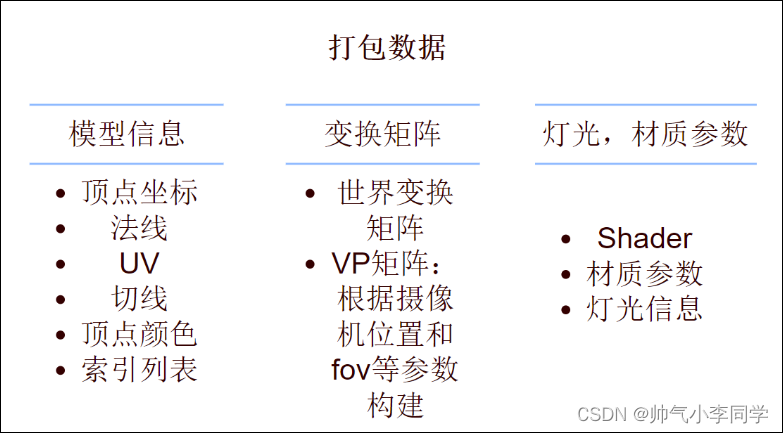
  1. CPU打包数据:vertex buffer/index buffer/frustum视锥/directional light平行光/texture+shader
    • SetPass Call:设定好渲染设置后,告诉GPU使用哪个shader,使用哪种混合模式、设置背面剔除等等,当使用不同的材质或者相同的材质下不同的Pass时需要设置切换多个渲染状态,就会增加SetPassCall,所以SetPassCall的次数也能反映性能
    • Draw Call(绘制调用):CPU打包数据发送给GPU,告诉GPU使用哪些模型数据进行渲染
  2. Vertex Shader: 使用顶点/视锥信息将模型空间变换到屏幕空间
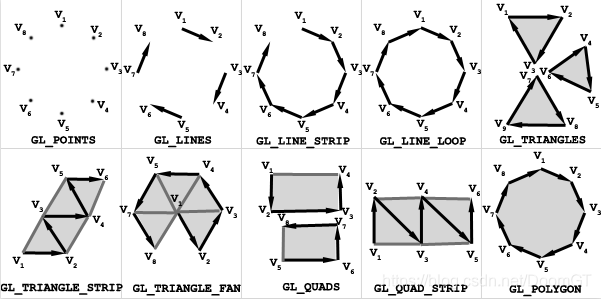
  3. Triangle Processing 图元装配:把顶点信息按照缓存连接成三角形图元
  4. Rasterization:插值计算出三角形每个像素的深度/颜色
  5. Pixel Shader (i.e. Fragment Shader):根据灯光/纹理贴图采样
  6. Frame Buffer:post processing 抗锯齿 校色 景深(DOF) 动态模糊


顶点着色器 vs 片元着色器

One main difference is that a vertex shader can manipulate the attributes of vertices. which are the corner points of your polygons.
The fragment shader on the other hand takes care of how the pixels between the vertices look. They are interpolated between the defined vertices following specific rules.

顶点着色器(Vertex Shader)

顶点着色器是图形渲染管线中的第一个可编程阶段。它的主要任务是处理从CPU发送到GPU的顶点数据。每个顶点都会通过顶点着色器进行一次,通常用于执行以下操作:

  • 变换:将顶点从模型空间转换到世界空间,然后进一步转换到视图空间和投影空间。这通常涉及到矩阵乘法运算,用于实现平移、旋转和缩放等变换。
  • 光照计算(可选):在某些情况下,顶点着色器也用于执行初步的光照计算,但这通常是在更简单的渲染场景中,或者作为更复杂的片元级光照计算的一个初步步骤。
  • 传递数据:顶点着色器可以计算并传递额外的数据到后续的渲染阶段,如片元着色器。这些数据可以是颜色、纹理坐标或其他自定义属性。

片元着色器

片元着色器是图形渲染管线中处理像素级渲染的阶段。它接收由顶点着色器插值得到的片元(即屏幕上的像素或像素的候选者),并生成最终的颜色和其他与像素相关的数据。以下是片元着色器的一些主要用途:

  • 纹理映射:从纹理中读取颜色信息,并应用到相应的像素上。这可以用于实现贴图、细节增强等效果。
  • 光照计算:执行更详细的光照计算,如计算每个像素上的光照强度和颜色。这可以包括漫反射、镜面反射、环境光等多种光照模型。
  • 颜色混合和特殊效果:实现各种颜色混合模式,以及应用如模糊、发光、深度测试等后处理效果。
  • 输出最终颜色:基于上述计算,确定每个像素的最终颜色,并将其发送到渲染管线的下一个阶段(通常是帧缓冲区)。

图元 vs 片元

  • 图元

渲染图元(rendering primitives)为图形渲染开发接口中用来描述各种图形元素的图形数据,所对应的就是绘图界面上看得见的实体,它包括了渲染所需的几何信息,可以是顶点数据、线段、多边形等。


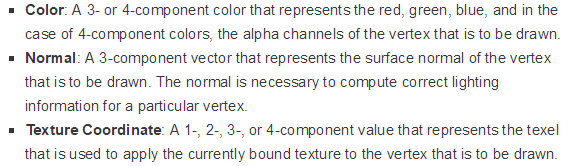
图元至少要包含一个顶点(Vertex);一个顶点定义了2D或3D坐标系中一个点,也同样定义了若干个可以影响如何把顶点渲染到屏幕上的属性,如:


  • 片元

在GPU流水线中的三角形遍历阶段,将会检查每个像素是否被一个三角网格所覆盖;如果被覆盖的话,就会生成一个片元(fragment);需要注意的是,一个片元并不是真正意义上的像素,而是包括了很多状态的集合,这些状态用于计算每个像素的最终颜色;这些状态包括了(但不限于)它的屏幕坐标、深度信息,以及其它从几何阶段输出的顶点信息,例如法线、纹理坐标等。


Credits

https://blog.csdn.net/lel18570471704/article/details/134708949
https://zhuanlan.zhihu.com/p/667522425
https://zhuanlan.zhihu.com/p/407046161
图元vs片元:https://blog.csdn.net/DoomGT/article/details/115806364


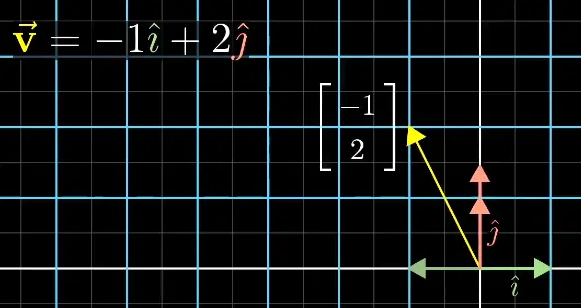
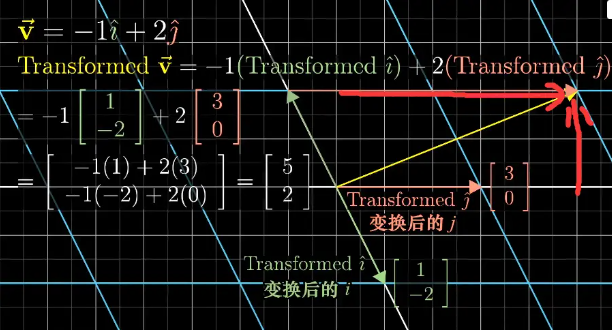
固定坐标系下,一个对象的变换等价于固定对象所处的坐标系变换。


经过线性变换(直线依旧是直线,保持网格线平等且等距分布,并且原点保持固定):


如图,新坐标系的基就是那个绿箭头和红箭头,在原来的ij坐标系下的坐标值是[1,-2]和[3,0]。经过如图的计算过程,坐标系的变化,导致原来的V向量变成了[5,2],实现了移动。

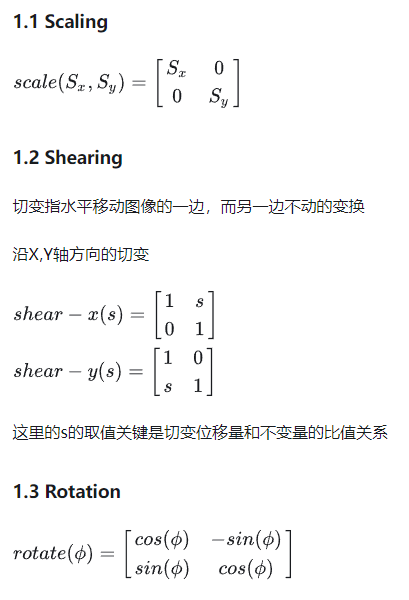
Transformation Matrix

常见的变换矩阵类型:

四元数的定义

四元数(Quaternion)是带有一个实部和三个虚部的一种扩展复数,有两种表达方式

  1. 标量形式

  2. 标量+向量形式

由于标量表达式中的 i,j,k 可以理解为相互正交的3个单位向量,于是四元数也可以表示为标量+向量的形式

四元数相关运算

存在qa,qb两个四元数

共轭(conjugate):

取逆(inverse):

取模(magnitude):

乘法:

四元数表示旋转

从二维平面复数的乘法中,我们可知:
表示某条射线的复数 和 表示旋转角度的复数,其乘积为该射线按旋转角度旋转后的射线所表示的复数,那么四元数可以理解为其在三维空间的拓展应用。
实际上,四元数是一种表示三维姿态的方法,其特点是紧凑、易于迭代、又不会出现奇异值。


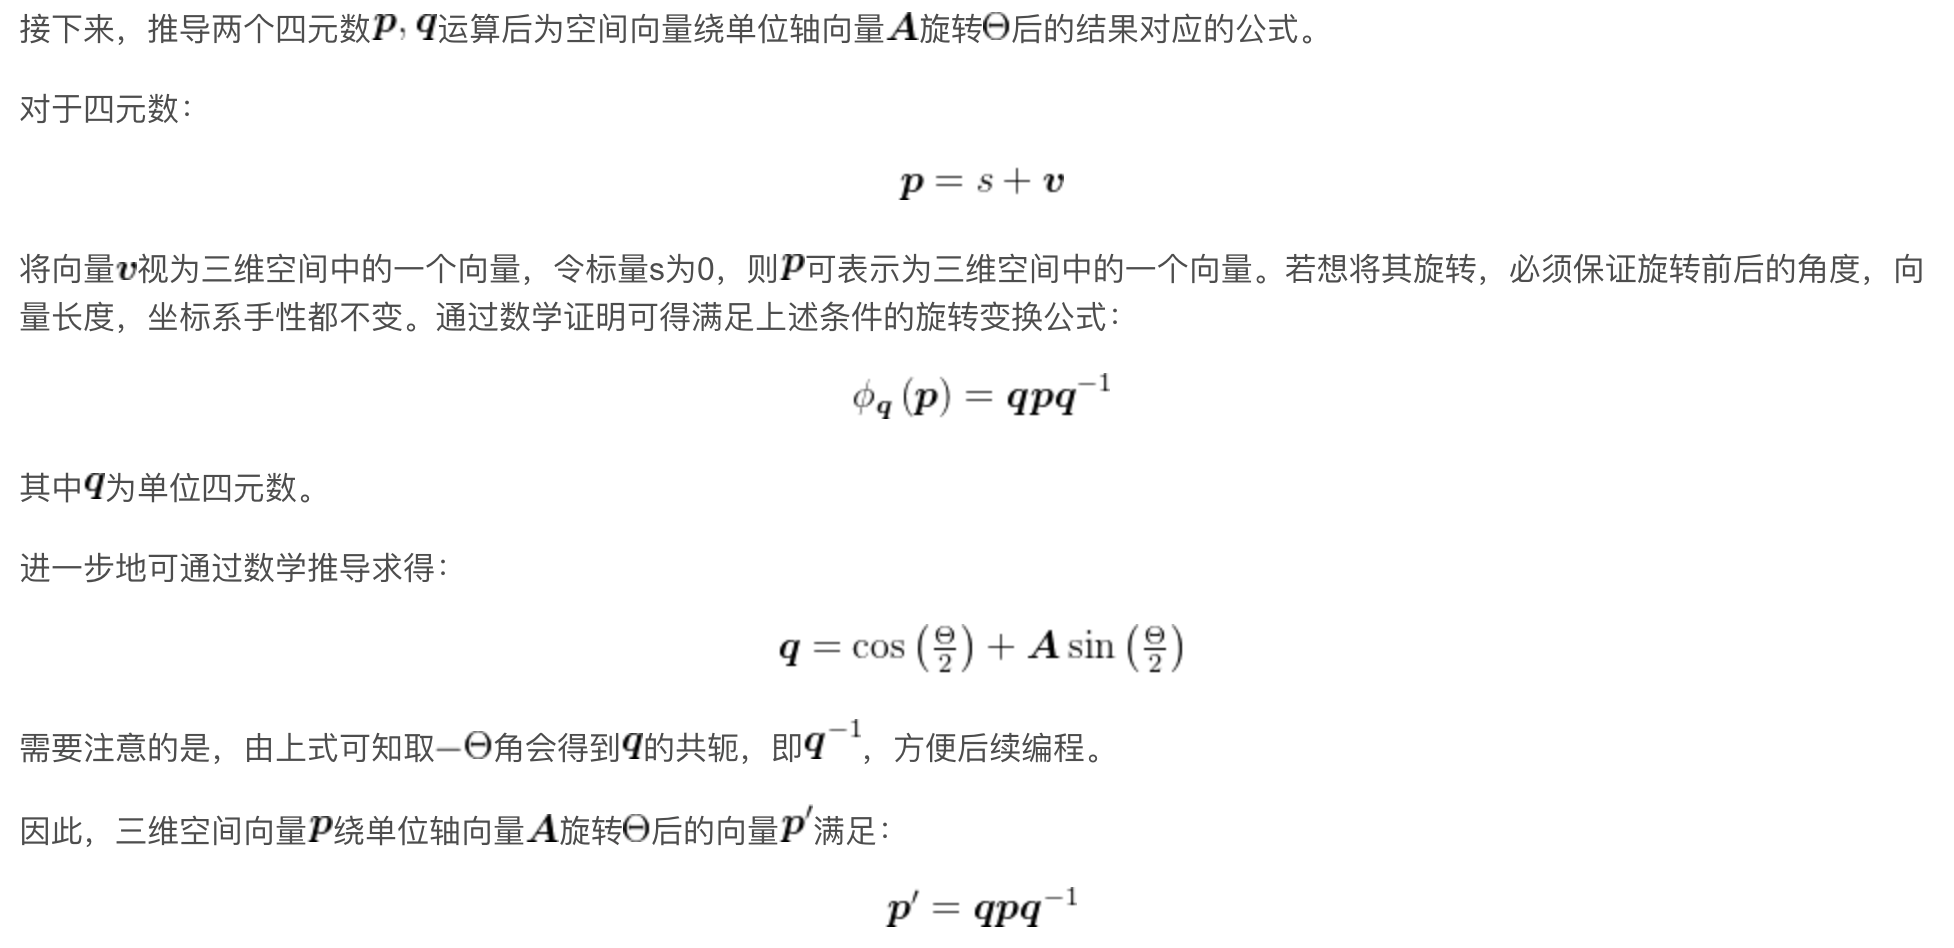
Unity C#四元数代码实现旋转

从欧拉角转换为四元数
1
2
Vector3 eulerAngles = new Vector3(45f, 30f, 60f); // 欧拉角
Quaternion quaternion = Quaternion.Euler(eulerAngles); // 转换为四元数
从欧拉角转换为四元数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
public class RotateByQuaternion : MonoBehaviour
{
public float rotateSpeed = 300.0f; // 旋转速度

void Update()
{
// 如果用户按下鼠标左键,则旋转对象
if (Input.GetMouseButton(0))
{
// 获取鼠标移动的x和y量
float mouseX = Input.GetAxis("Mouse X") * rotateSpeed * Time.deltaTime;
float mouseY = Input.GetAxis("Mouse Y") * rotateSpeed * Time.deltaTime;

// 创建一个四元数,表示绕Vector3.up轴旋转mouseY度,绕Vector3.right轴旋转mouseX度
Quaternion rotation = Quaternion.AngleAxis(mouseY, Vector3.up) * Quaternion.AngleAxis(mouseX, Vector3.right);

// 应用这个旋转到游戏对象上
transform.rotation *= rotation;
}
}
}

Credits

利用四元数表示空间向量的旋转:https://blog.csdn.net/qq_42648534/article/details/124072859


Unity 2022.3 Camera Component


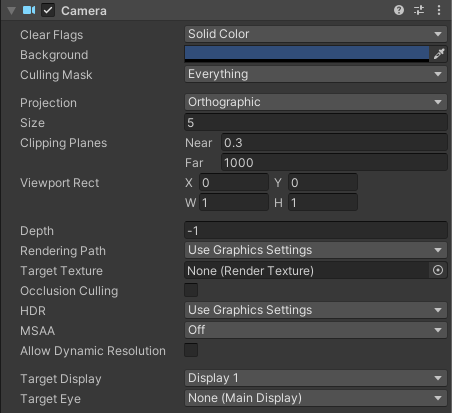
相机参数

Clear Flags(清除标记):

A camera in Unity holds info about the displayed object’s colors and depths.
In this case, depth info means the game world distance from the displayed object to the camera.

When a camera renders an image it can get rid of all or just some of the old image information and then displays the new image on top of what’s left.
Depending on what clear flags you select, the camera gets rid of different info.

  • The skybox clear flag means that when the camera renders a new frame, it clears everything from the old frame and it displays the new image on top of a skybox.
  • The solid color clear flag means that when the camera renders a new frame, it clears everything from the old frame and it displays the new image on top of a solid color.
  • The depth only clear flag means that when the camera renders a new frame, it clears only the depth information from the old frame and it keeps the color information on top of which displays the new frame. This means that the old frame can still show but it doesn’t have depth information, meaning the new objects to be displayed can’t be shown as intersected or obstructed by the old objects, because there’s no information about how far the old objects are(depth info was cleared). So the new objects will be on top of the old ones, mandatory.

Background(背景):

The color applied to the remaining screen after (1) all elements in view have been drawn and (2) there is no skybox.

Culling Mask(剔除遮罩):

Includes or omits layers of objects to be rendered by the Camera.

Projection(投射方式):

  • Perspective(透视): Camera will render objects with perspective intact.
    • Field of view: The Camera’s view angle, measured in degrees along the axis specified in the FOV Axis drop-down.
  • Orthographic(正交): Camera will render objects uniformly, with no sense of perspective. NOTE: Deferred rendering is not supported in Orthographic mode. Forward rendering is always used.
    • Size: The viewport(The user’s visible area of an app on their screen.) size of the Camera when set to Orthographic.

Clipping Planes(剪裁平面):

Distances from the camera to start and stop rendering.

  • Near(近点): The closest point relative to the camera that drawing will occur.
  • Far(远点): The furthest point relative to the camera that drawing will occur.

Normalized Viewport Rect(标准视图矩形):

Four values that indicate where on the screen this camera view will be drawn. Measured in Viewport Coordinates (values 0–1).

  • X: The beginning horizontal position that the camera view will be drawn.
  • Y: The beginning vertical position that the camera view will be drawn.
  • W: Width of the camera output on the screen.
  • H: Height of the camera output on the screen.
    It’s easy to create a two-player split screen effect using Normalized Viewport Rectangle. After you have created your two cameras, change both camera’s H values to be 0.5 then set player one’s Y value to 0.5, and player two’s Y value to 0. This will make player one’s camera display from halfway up the screen to the top, and player two’s camera start at the bottom and stop halfway up the screen.

Depth(相机深度):

The camera’s position in the draw order. Cameras with a larger value will be drawn on top of cameras with a smaller value.

Rendering Path(渲染路径):

Options for defining what rendering methods will be used by the camera.

  • Use Graphics Settings: This camera will use whichever Rendering Path is set in the Project Settings -> Player
  • Forward(快速渲染): 摄像机将所有游戏对象将按每种材质一个通道的方式来渲染。对于实时光影来说,Forward的消耗比Deferred更高,但是Forward更加适合用于半烘焙半实时的项目。Forward解决了一个Deferred没能解决的问题:Deferred不能让Mixed模式的Directional Light将动态阴影投射在一个经过烘焙了的静态物体上。
  • Deferred(延迟光照): 最大的特点是对于实时光影来说的性能消耗更低了,这个模式是最适合动态光影的。对于次时代PC或者主机游戏, 当然要选择这个。次时代游戏几乎不需要烘焙光照贴图了,全都使用实时阴影是很好的选择。通过阴影距离来控制性能消耗。而在Viking Village的场景中,由于整个场景全部使用了动态光源,Forward的Rendering方面的性能消耗要比Deferred高出一倍! 因此在完全使用动态光源的项目中千万不能使用Forward。
  • Vertex Lit(顶点光照): All objects rendered by this camera will be rendered as Vertex-Lit objects.

Rendering path is the technique that a render pipeline uses to render graphics. Choosing a different rendering path affects how lighting and shading are calculated. Some rendering paths are more suited to different platforms and hardware than others.

  • Forward vs Deferred Rendering

Forward rendering does all of the work for rendering geometry up front when it gets submitted to the rendering pipeline. You submit your geometry and materials to the pipeline, and at some point the fragments(pixels) that represent your geometry are calculated and invokes a fragment shader to figure out the final “color” of the fragment based on where it is located on the screen (render target). This is implemented as logic in a pixel shader that does the expensive lighting and special effects calculations on a per-pixel basis.

The inefficiency with this approach is, when pixels get overwritten by geometry submitted later in the pipeline that appear in front of it. You did all of that expensive work for nothing. Enter deferred rendering:

Deferred rendering should really be called deferred shading because the geometry is (or can be) submitted to the pipeline very much in the same way as forward rendering. The difference is that the result is not actually a final color value for the final image. The pipeline is configured in a way such that instead of actually going through with the calculations, all of the information is stored in a G-buffer to do the calculations later. That way, this information can be overwritten multiple times, without ever having calculated the final color value until the last fragment’s information is written. At the very end, the entire G-buffer is processed and all of the information it stored is used to calculate the final color value.

Last words:

Neither technique is really harder to learn. We’re just coming from a forward rendering past. Once you have a good grasp of deferred rendering (and perhaps have a solid computer graphics background), you realize it’s just another way to do things.

It’s hard to say which technique is better. As pixel/fragment shaders get more GPU processing expensive, deferred shading becomes more effective. If early Z testing (https://docs.unity3d.com/6000.0/Documentation/Manual/SL-ZTest.html) can be employed or other effective culling techniques are used, deferred shading becomes less important. G-buffers also take up a lot of graphics memory.

Target Texture(目标纹理):

相机渲染不再显示在屏幕上,而是映射到纹理上。一般用于制作导航图或者画中画等效果。

Reference to a Render Texture that will contain the output of the Camera view. Setting this reference will disable this Camera’s capability to render to the screen.
Render Texture is a special type of Texture that is created and updated at runtime. To use them, first create a new Render Texture and designate one of your Cameras to render into it. Then you can use the Render Texture in a Material just like a regular Texture.

Occlusion Culling(遮挡剔除):

Occlusion culling is a process which prevents Unity from performing rendering calculations for GameObjects that are completely hidden from view (occluded) by other GameObjects, for example if they are behind walls. (https://docs.unity.cn/Manual/OcclusionCulling.html)

  • Unity can bake static GameObjects (does not move at runtime) into the occlusion culling data as a Static Occluder and/or a Static Occludee.
  • Unity cannot bake dynamic GameObjects into the occlusion culling data. A dynamic GameObject can be an occludee at runtime, but it cannot be an occluder.

Allow HDR(渲染高动态色彩画面):

Enables High Dynamic Range rendering for this camera.

Allow MSAA(硬件抗锯齿):

Enables multi sample antialiasing for this camera.

Allow Dynamic Resolution(动态分辨率渲染):

Enables Dynamic Resolution rendering for this camera.

Target Display(目标显示器):

A camera has up to 8 target display settings. The camera can be controlled to render to one of up to 8 monitors. This is supported only on PC, Mac and Linux. In Game View the chosen display in the Camera Inspector will be shown.


Credits

Unity documentation: https://docs.unity.cn/Manual/class-Camera.html
Unity 摄像机参数介绍:https://blog.csdn.net/Scopperil/article/details/80440448